
Ксения Афанасьева — редактор
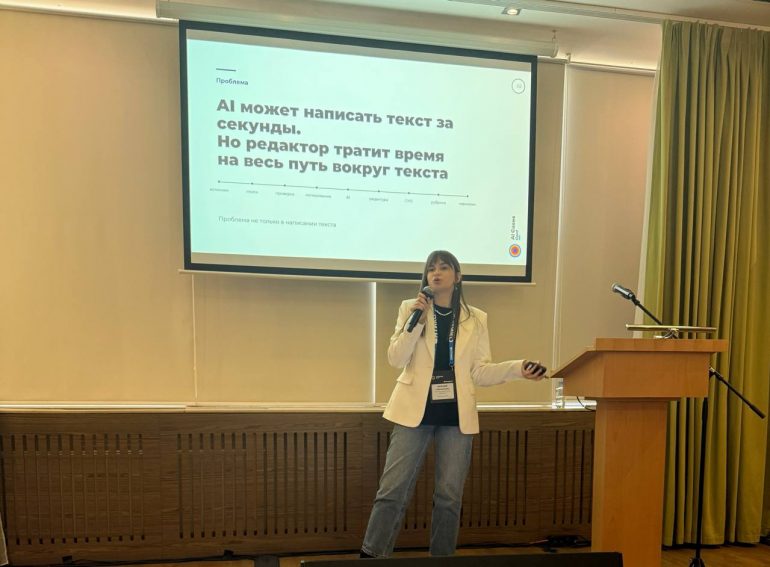
На AI Cases Conf 2026 я рассказывала о том, как из попытки ускорить подготовку новостей выросла внутренняя редакционная система «Фактура». В процессе стало понятно, что сама работа с текстом занимает только часть времени. Значительная доля ручной работы приходится на поиск информации, перенос данных, проверку результата, маршрутизацию и передачу материала дальше.
Где на самом деле теряется время
До появления системы мне и другим редакторам приходилось самостоятельно проходить всю цепочку: просматривать источники, находить новость, открывать и читать материал, копировать исходник, переходить в отдельный AI-сервис, запускать обработку и ждать результата. После этого текст нужно было проверить, при необходимости отредактировать, выбрать заголовок и лид, перенести материал в CMS, определить рубрику и создать публикацию.
По отдельности эти действия несложные. Проблема возникает из-за количества повторяющихся переключений — открыть, скопировать, вставить, проверить, перенести, выбрать. Одна и та же последовательность запускается практически для каждой новости.
Поэтому я поставила себе другую задачу: не автоматизировать редакционное решение, а убрать рутину.
После появления «Фактуры» источники стали собираться автоматически, материалы — попадать в рабочую очередь, а система — заранее обрабатывать текст. Редактор подключается уже к подготовленной новости: проверяет результат, при необходимости вносит изменения, выбирает редакцию и рубрику. Затем система создает черновик, но перед публикацией остается человеческая проверка.
В интерфейсе исходный материал и результат находятся рядом. Это позволяет сразу сверять цифры, формулировки и смысл с первоисточником, а не принимать подготовленный AI текст на веру.
AI оказался только одним из компонентов
По мере развития системы у меня изменилось и представление о том, что вообще считать AI-инструментом. Сбор материалов, очередь, статусы, контроль повторов, маршрутизация, рубрики и создание черновика не требуют работы языковой модели. AI подключается там, где начинается работа непосредственно с текстом: рерайт, заголовки, лид, теги и варианты формулировок.
Я пришла к довольно простому выводу: сначала надо проектировать рабочий процесс, а уже потом решать, где внутри него действительно нужен AI.
Замена одной модели на более сильную сама по себе не решает проблему ручного труда, если вокруг нее по-прежнему приходится самостоятельно собирать информацию, переносить данные и переключаться между несколькими сервисами. Поэтому центральной задачей становится не выбор модели, а устройство всей цепочки до и после ее ответа.
Правила приходится формализовать
Отдельной задачей стала редакционная политика. Простой команды «перепиши текст» для рабочего процесса оказалось недостаточно.
В инструкции модели пришлось закрепить границы: не добавлять сведения, которых нет в исходнике, не использовать внешние знания, сохранять цифры, даты и юридически значимые формулировки, не менять прямые цитаты. Отдельные правила действуют для заголовков.
Инструкция формировалась постепенно. Я получала результат, находила проблему, добавляла или уточняла правило и снова проверяла систему. Даже подробная инструкция не дает стопроцентной гарантии и не отменяет редакционную проверку.
Фактически мне пришлось переводить в формальные правила часть решений, которые редактор обычно принимает автоматически и не проговаривает. Та же проблема возникла и при создании самой панели: нужно было определить, когда материал считается обработанным, как не допустить дубль, как передать новость в другое направление и что делать, если она подходит нескольким направлениям.
Система поэтому развивалась не из большого технического задания, составленного заранее. Сначала появилась простая версия, а новые функции добавлялись по мере возникновения повторяющихся рабочих ситуаций: статусы, контроль повторов, маршрутизация, редакции и рубрики.
Где остается человек
Значительную часть повторяющейся работы системе можно передать: собрать материал, подготовить текст, сделать рерайт, предложить варианты, перенести данные и создать черновик.
Но ряд решений я сознательно оставила редактору. Нужно ли вообще брать новость? Насколько она значима? Совпадает ли результат с источником? Нет ли ошибки в цифрах? Можно ли публиковать именно такую формулировку?
Для меня граница проходит примерно так: чем выше потенциальная цена ошибки, тем меньше смысла пытаться убрать человека из процесса.
Поэтому конечным результатом автоматизированной цепочки стал черновик, а не публикация. Технически процесс можно продолжить дальше, но задача состояла не в максимальной автономности, а в сокращении ручной работы без отказа от контроля. Ошибку в черновике можно заметить и исправить до публикации.
Экономика складывается не из цены запроса
По предварительной оценке на типовых задачах, ручная подготовка одной новости занимала примерно 15–20 минут. С панелью тот же путь может сокращаться примерно до 5–7 минут. Потенциально речь идет о сокращении времени примерно на 60–70%.
Я не рассматриваю эти цифры как окончательный KPI. Основной эффект возникает не потому, что модель стала писать в несколько раз быстрее, а за счет сокращения ручных переключений между источниками, AI, CMS и внутренними операциями.
В докладе я приводила и условный расчет стоимости работы с одной новостью. При ставке редактора 70 тыс. рублей в месяц и примерно 30 новостях в день ручная работа над одной новостью оценивалась примерно в 100–106 рублей. При сокращении времени до 5–7 минут — примерно в 33 рубля. Это не бухгалтерская себестоимость, а способ сравнивать разные варианты работы в одной системе координат.
Сейчас системой пользуются около десяти человек. В среднем она выполняет примерно 982 обращения к OpenAI API в неделю. Расходы на AI составляют около $4 в неделю, на сервер — примерно 1 тыс. рублей в месяц.
За последние 30 дней через панель прошло 2 991 материалов. В среднем это около 100 материалов в день, а в будни поток обычно достигает примерно 120–170.
При выборе модели я смотрю не только на стоимость самого обращения. В одном из тестов одинаковую задачу с одной редакционной инструкцией получили международная, китайская и российская модели. Я сравнивала фактическую точность, соблюдение правил, качество русского текста, заголовки и объем ручной правки до публикации.
Выбирать модель только по цене запроса, на мой взгляд, слишком узко. Если дешевый ответ потом нужно долго переписывать руками, экономии может не быть.
В июне система выполнила 909 запросов, расходы составили $20,51. После перехода на более дешевую модель стоимость обработки снизилась примерно до $4–5 в неделю. После этого мой вопрос сместился с цены отдельного обращения к стоимости всего процесса и времени человека, которое он занимает.
Следующий шаг — работа с данными
Одним из следующих направлений я рассматриваю подключение внешних информационных и аналитических систем через API. Тогда система сможет не только собирать готовые публикации, но и замечать изменения в данных, из которых потенциально может появиться инфоповод.
Еще одно направление — разные каналы выпуска, включая сайт и Telegram, с отдельными правилами. Эти возможности пока не реализованы в текущей версии.
При этом логика дальнейшего развития остается той же, что использовалась при создании панели: сначала должен появиться понятный рабочий сценарий, его ценность и риск, а уже после этого — техническое решение.
Если собрать весь кейс в одну мысль, то для меня хороший AI-инструмент — это не тот, который делает всё сам. Это тот, который сокращает путь до качественного решения, оставляет результат проверяемым и не забирает ответственность там, где она действительно важна.